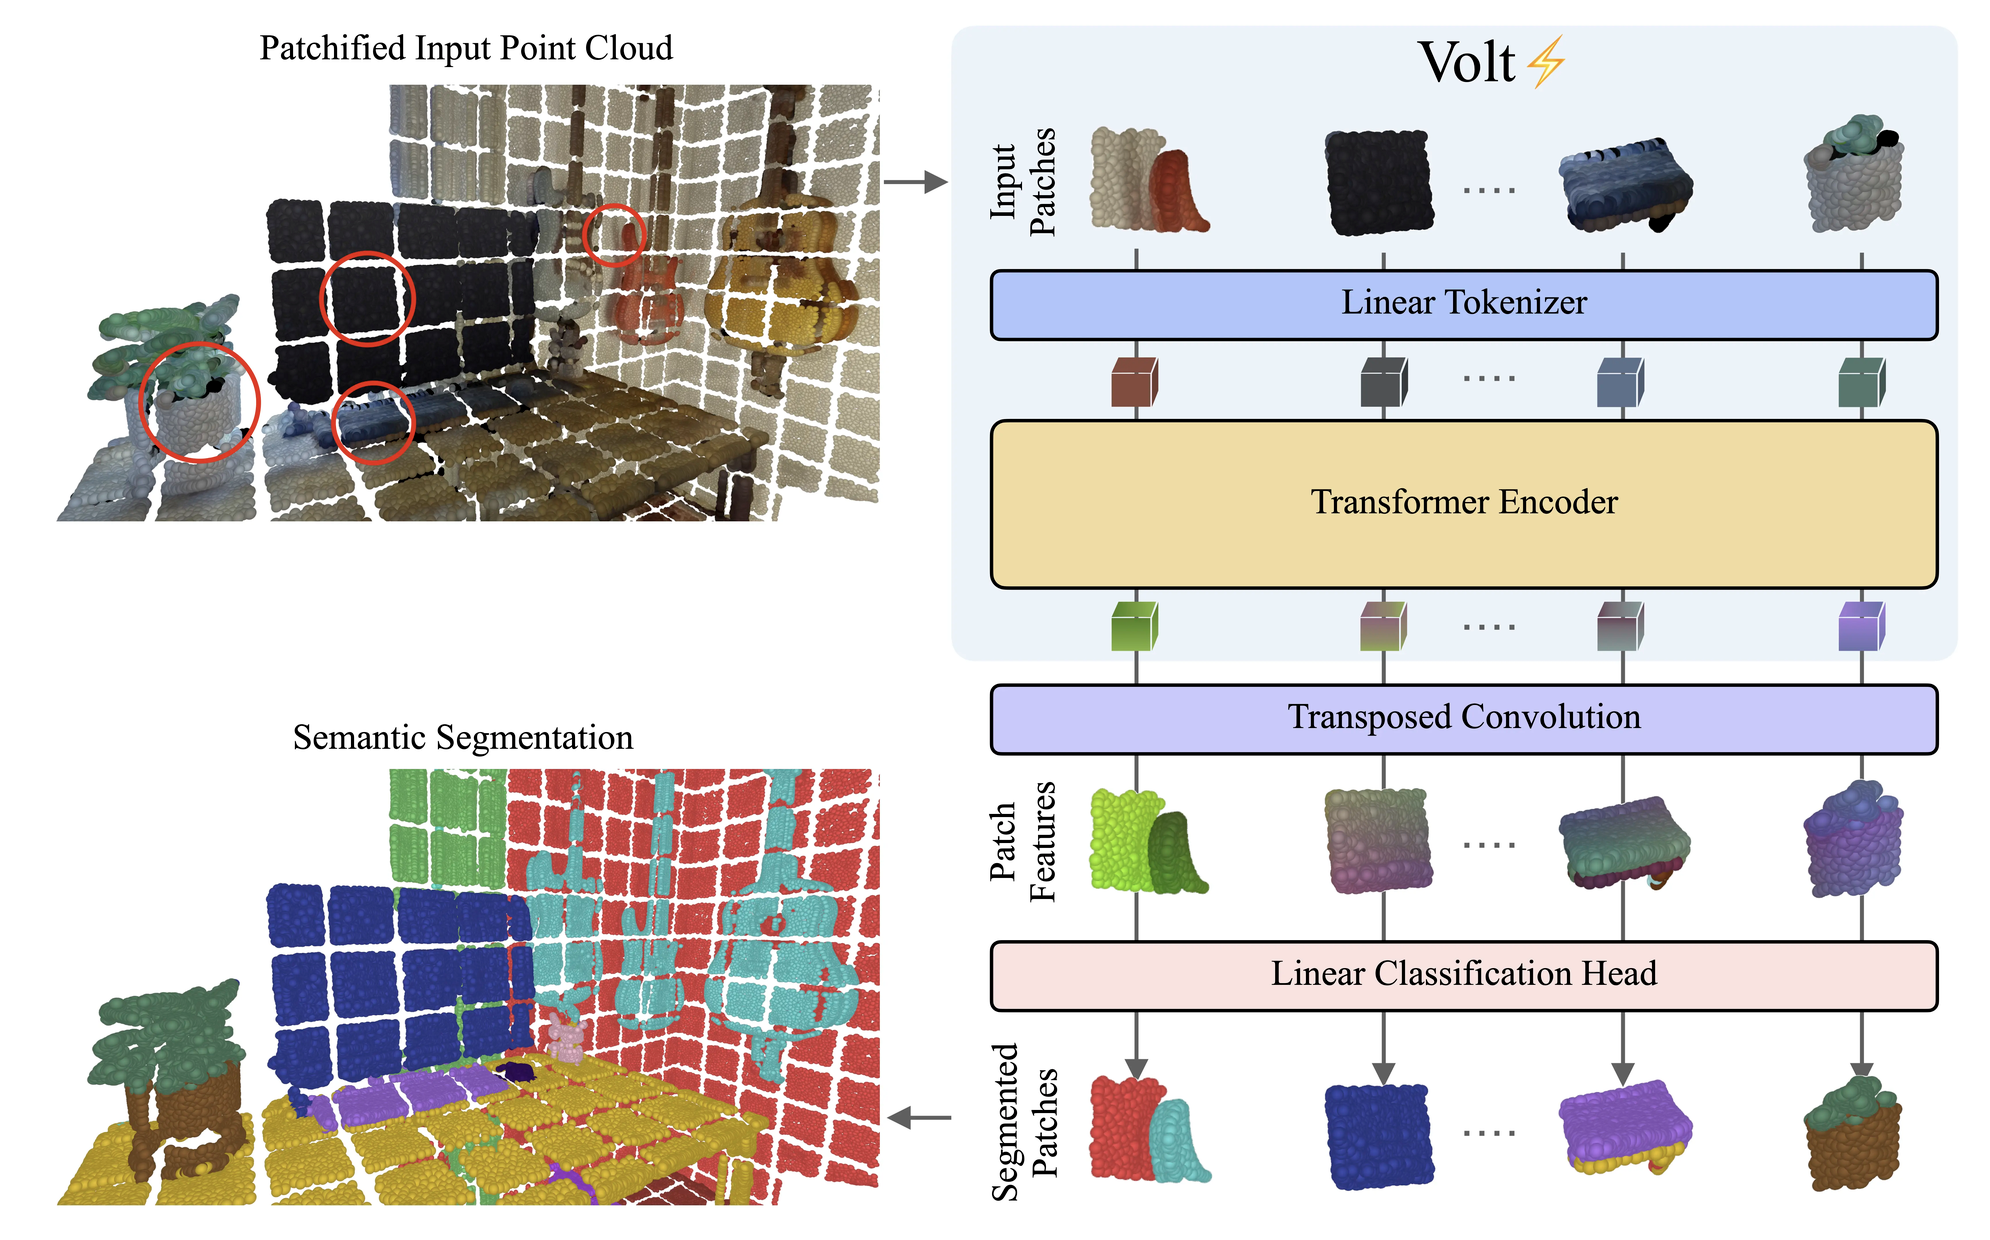
Volume Transformer: Revisiting Vanilla Transformers for 3D Scene Understanding
A vanilla Transformer for 3D scenes, with volumetric patch tokens, global attention, and a training recipe that scales across datasets.
BibTeX
@inproceedings{yilmaz2026Volt,
  title = {Volume Transformer: Revisiting Vanilla Transformers for 3D Scene Understanding},
  author = {Yilmaz, Kadir and Kruse, Adrian and Höfer, Tristan and de Geus, Daan and Leibe, Bastian},
  booktitle = {European Conference on Computer Vision (ECCV)},
  year = {2026}
}